
Decision 3.0 登上苹果芯片:文本、图像与视频决策在一台 Mac 上完成

导语:vLLM Semantic Router 团队宣布 Decision 3.0 已在苹果芯片上运行。
摘要
vLLM Semantic Router 团队宣布 Decision 3.0 已在苹果芯片上运行。该模型系列的特点是"只判卷、不写字":传入一段状态与一组具名问题,模型单次前向即可返回每个选项的得分,不生成任何文本。此次三款较小规格(d3-lite 0.8B、d3-nano 2B、d3-mini 4B)被转换为 Core ML,并在 M5 Pro 上完成文本、截图与实时视频三类演示。官方表示,在 Mac 上做出的决策没有单次调用成本、没有网络往返,PR、网页或视频内容不会离开本机。精度方面,转 Core ML 后在 JevBench 公开集与 typed-decisions TEST 上与上游 PyTorch 基本持平,单次请求快 2.5 至 4 倍。
正文(译文)
Decision 3.0 登上苹果芯片:在 Mac 上完成文本、图像与视频决策
Decision 3.0 已经可以在 Mac 上运行。Decision 3.0 把文本、图像和视频决策整合进同一个开放模型家族。我们把三个较小的规格(d3-lite 0.8B、d3-nano 2B、d3-mini 4B)转换成了 Core ML,并针对文本、截图和实时视频做了演示。在 Mac 上做出的决策没有单次调用成本,也没有网络往返,拉取请求、网页或视频都不会离开这台机器。这与 vLLM-SR 形成配合:常规判断可以在设备端得到答案,需要更大模型的再交给路由器处理。
获取 Core ML 模型 → ・ Swift 运行时 → ・ 在 X 上观看演示 →
转换是如何做的
每个 d3 模型都是一个 Qwen3.5 主干,加上一个小型 FP32 读出头,在最后一个提示 token 处为每个选项打分,每个问题一次前向。Core ML 承担重的部分,即主干和视觉塔;宿主应用负责周边轻量步骤:嵌入的查表、位置的算术运算,以及读出头的一次小型矩阵乘法。
具体来说:
文本图跑在 Core ML 上。 主干以 token 嵌入为输入,因此图像和视频 token 可以在它运行之前拼接进来。提示右侧填充到几个固定长度。这对 d3 是精确的:Gated DeltaNet 层是因果的,永远不会看到填充;全注意力层则把填充遮蔽掉。
视觉塔跑在 Core ML 上。 它以 fp32 运行,patch 数量固定,并对填充做遮蔽。对于视频,一个块对角掩码把注意力限制在每一帧对内部,与上游一致。
宿主侧。 token 嵌入、M-RoPE 位置和 255 路读出在 numpy(或 Swift)中以 FP32 运行。提示来自上游自身的请求准备逻辑,在一个未加载权重的 d3 上执行,因此每个提示、时间戳和位置都与上游完全一致。
8 位权重。 在 fp16 下,d3-mini 的文本图每个长度桶占 6.7GB。在一台 24GB 内存的 Mac 上同时加载两个桶会导致 GPU 换页,每步 8 至 12 秒。改用 8 位权重后,两个桶都能常驻。转换使用 PyTorch 2.7 与 coremltools 9.0。
我们在两个公开基准上把 Core ML 版本与上游 PyTorch(在 Mac 的 GPU 上运行 bf16)做了对照:JevBench 公开套件,通过其未改动的 System One 适配器与打分器运行,方式与 System One Auto 一文一致;以及 typed-decisions 的 TEST 切分,对照其金标签打分。
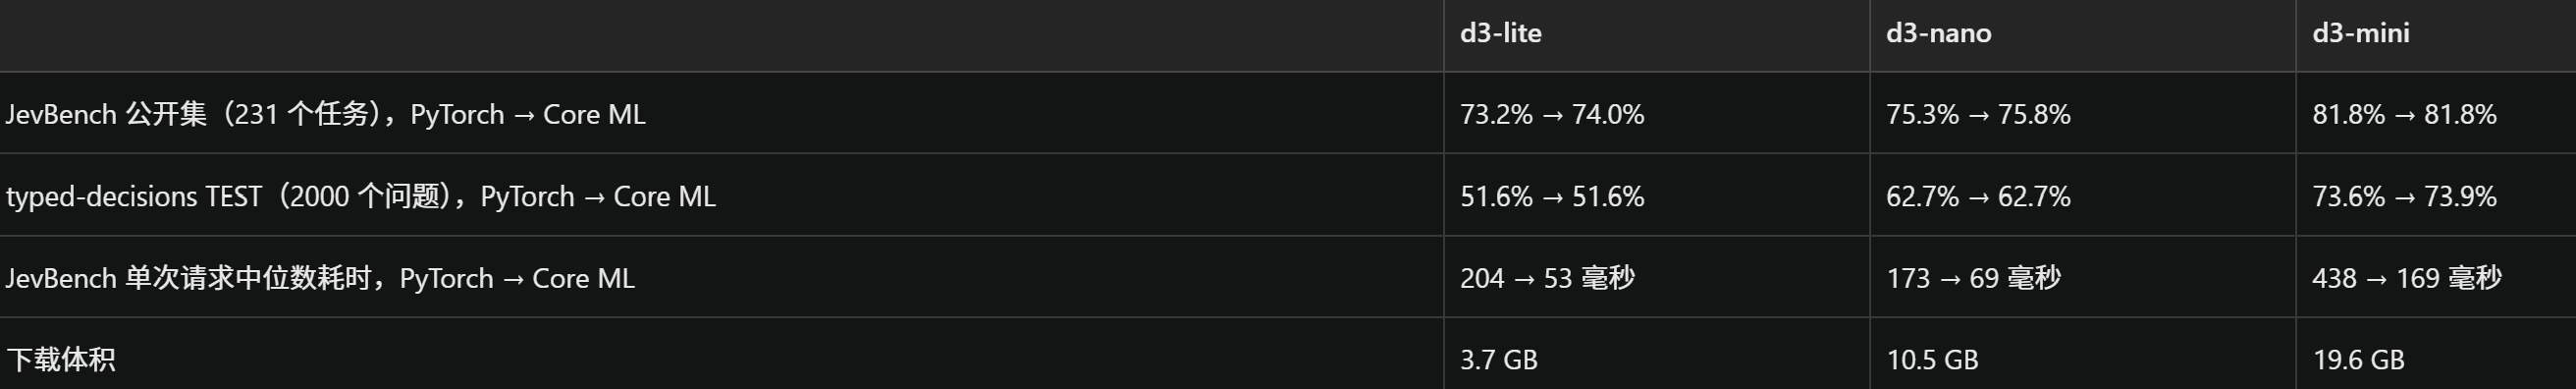
Core ML 的得分与上游一致,而每次请求快 2.5 至 4 倍。在 Mac 上,上游 PyTorch 对 DeltaNet 层会回退到 Transformers 的参考实现,因为它在 NVIDIA GPU 上使用的快速算子在这里不可用。所有数字均来自一台 MacBook Pro(M5 Pro,24GB),在 GPU 上运行。d3-nano 是中间选项:速度接近 d3-lite,而在 typed-decisions 上高出 11 个百分点。
方法与局限
两种后端都是一次处理一个请求。请求耗时包含一个本地 HTTP 往返。JevBench 的准确率是公开套件上的精确标签准确率,并非官方封闭排行榜或其综合得分。其中 37 个任务长度超过 1536 token(最长为 3970),因此本次发布包含一个 4096 token 的文本图。typed-decisions 的金标签来自多位标注者,彼此常有分歧,因此所有模型在该集上的准确率都明显低于 JevBench。
演示
d3-lite 负责速度优先的演示,d3-mini 负责截图与视频。
分拣拉取请求(d3-lite,演示视频见 X)。即顶部的视频。对于 1000 个样例拉取请求,d3-lite 读取标题、描述开头和变更文件,然后回答两个问题:它属于七个 vLLM-SR 工作组中的哪一个,以及这是哪一类变更。每个 PR 耗时 0.12 秒,即每秒处理 8.3 个 PR、做出 16.5 次判断。在真实的 vLLM-SR 拉取请求上,d3-mini 在 168 个中的 134 个上与维护者的工作组标签一致,在 182 个中的 153 个上与变更类型标签一致。
d3-mini 在 Chrome 中操作真实网站。 目标:打开 Travel 分类下一本五星评级的书。d3-mini 根据截图选择每一次点击。d3-mini 接收一个目标,以及一张带有编号标记的 books.toscrape.com 截图,标出各链接。它选择下一次点击,读取页面上的书籍,并在找到满足目标的那一本时停止。在一个 17 目标的测试中,它达成了全部 17 个目标,每次点击约 2.2 秒。d3 读取数值的表现不错,但比较数值时可靠性较差:整页一次性选择只达成 17 个中的 9 个。而逐张读取书籍卡片、在代码中做比较,则达成了全部 17 个。
d3-mini 实时观察一个路口。 每当 d3-mini 空闲时,它查看最近 4 秒,时间线随其回答不断延长。视频:多伦多 Yonge 街与 Dundas 街的斜向人行横道(Raysonho,Wikimedia Commons,CC0)。随着视频播放,d3-mini 查看最近 4 秒(以其原生 2 fps 取 8 帧),并回答车辆是否在移动、是否有人在骑车。在 Core ML 上每次观察耗时 1.1 秒,而在同一台 Mac 上 PyTorch 需要 2.4 秒,回答大约落后实时视频 2 秒。
试试看
三个规格的 Core ML 模型都在 FluidInference/d3-coreml,每个文件夹都带一个基于 coremltools 的 Python 宿主。对于 Swift 应用,FluidUse 中的 D3Manager 可下载模型并响应请求。感谢 vLLM Semantic Router 团队提供 Decision 3.0 的早期访问。
(来源:艾瑞网)
